SEO & GEO Sander·Teamlead SEO, GEO & Website
Wat de langste Google spam-update van het jaar betekent voor jouw site
Sander·Teamlead SEO, GEO & Website Google Premier Partner
 Meta Business Partner
Onderzoek onder 407 .nl-sites: bijna 1 op de 4 blokkeert AI-crawlers als ChatGPT en Perplexity, vaak onbewust. Zo check en fix je het morgen.
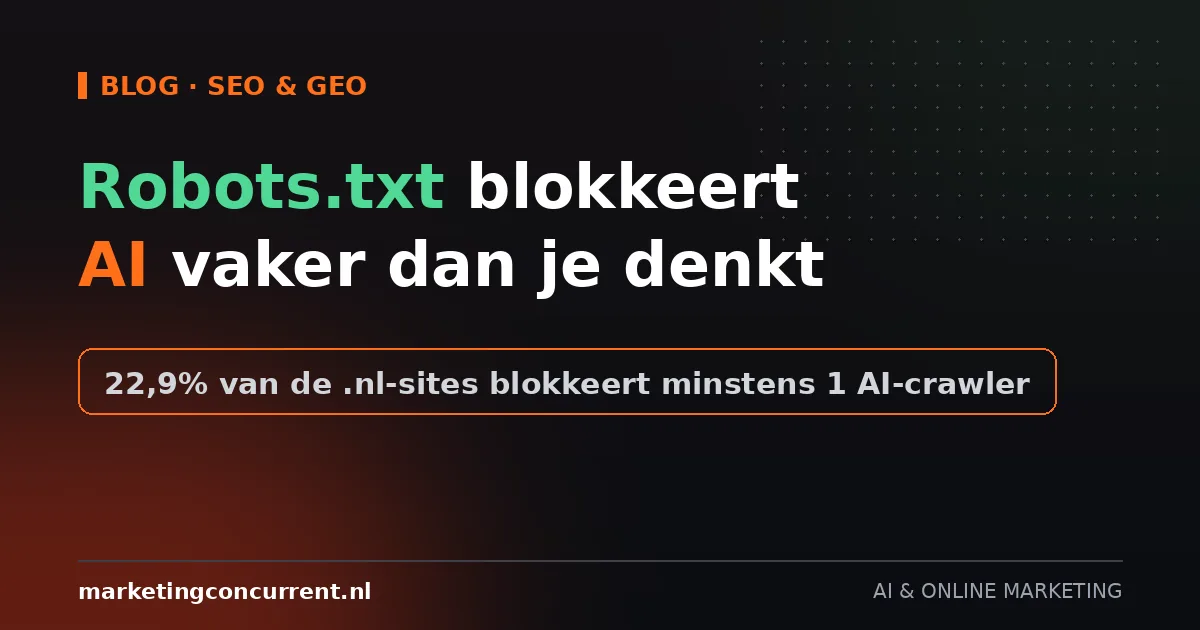
Bijna een kwart van de grootste Nederlandse websites houdt AI-zoeksystemen zoals ChatGPT en Perplexity buiten de deur, en dat is in de meeste gevallen geen bewuste keuze. Dat blijkt uit een doorlopende meting van onderzoeksbureau Writgo Media onder de vijfhonderd best genoteerde .nl-domeinen. Van de 407 sites die het bureau kon bereiken, blokkeert 22,9 procent minstens één AI-crawler volledig via robots.txt. Vijftien procent sluit drie of meer bots tegelijk uit. Voor een marketingmanager of ondernemer die net begint met werk maken van GEO betekent dit één ding vooral: controleer eerst of je site überhaupt binnenkomt, voordat je gaat nadenken over hoe je opvalt in een AI-antwoord. Wat je morgen kunt doen, staat verderop in dit artikel als concreet stappenplan.
Writgo Media scande de Tranco-ranglijst van .nl-domeinen en testte per site het robots.txt-bestand op veertien bekende AI-user-agents. Bij de eerste meting in juni 2026, gepubliceerd via Frankwatching, blokkeerde 21,1 procent van de onderzochte sites nog minstens één crawler. Begin september staat de teller op 22,9 procent. Het aantal sites dat AI weert, groeit dus eerder dan dat het afneemt.
Kijk je naar losse bots, dan is GPTBot van OpenAI het vaakst geblokkeerd (17,4 procent), gevolgd door CCBot van Common Crawl (16,7 procent), Bytespider van ByteDance (14,7 procent) en ClaudeBot van Anthropic (14,5 procent). Ook Google-Extended, de crawler die content ophaalt voor Gemini en AI Overviews, wordt door 13,5 procent van de sites uitgesloten. Opvallend is dat sites vooral druk zijn met blokkeren, terwijl bijna niemand iets doet om juist wel geciteerd te worden. Slechts 1,5 procent van de homepages heeft FAQ-schema staan, het opmaakformaat dat AI-systemen het makkelijkst kunnen citeren. Een llms.txt-bestand, een soort wegwijzer voor AI-systemen, heeft 8,6 procent. Structured data in enige vorm staat wel bij iets meer dan de helft van de sites, 52,1 procent.
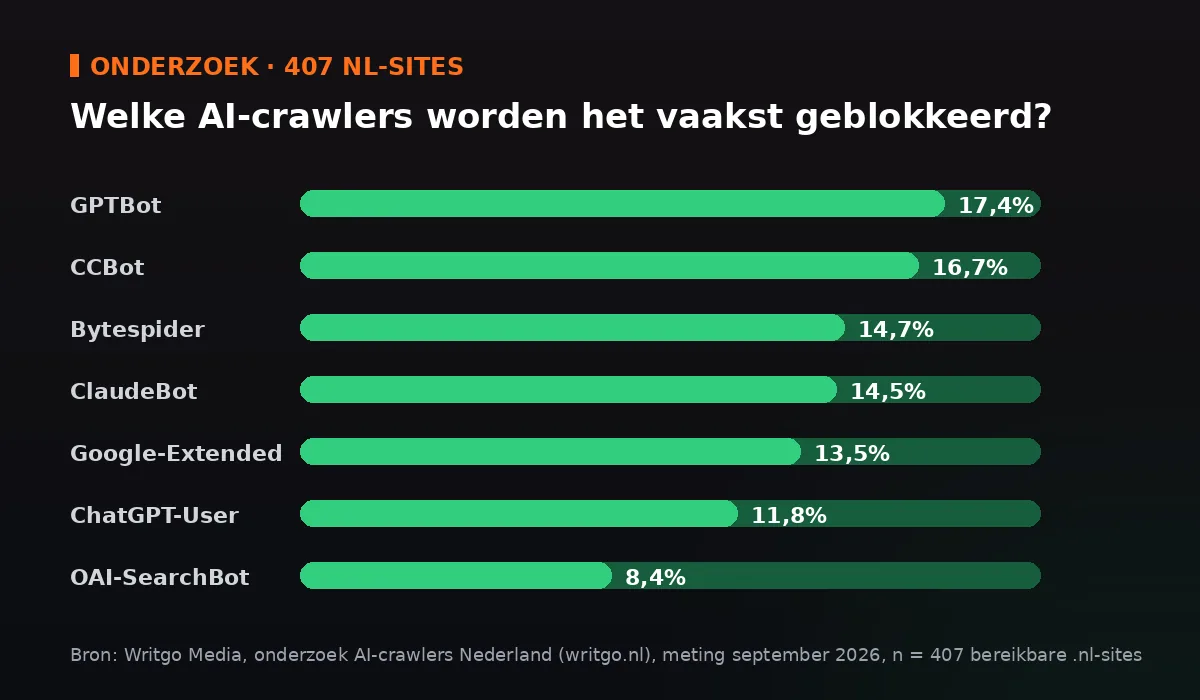
Bijna een kwart van de grootste Nederlandse sites zet de deur voor AI op slot, terwijl bijna niemand binnen die deur iets klaarlegt om te citeren.
Wij zien bij websites die we doorlichten zelden een expliciete beslissing om GPTBot of ClaudeBot te weren. Vaker is de oorzaak een robots.txt-bestand dat jaren geleden is opgesteld door een bureau of ontwikkelaar, en dat sindsdien niemand meer heeft aangeraakt. Security-plugins voor WordPress voegen soms standaard blokkades toe voor alles wat op een bot lijkt, inclusief AI-crawlers. En omdat robots.txt geen zichtbaar onderdeel van de site is, valt het simpelweg niet op. Iemand kopieert een template van een andere site, of neemt een regel over uit een tutorial van drie jaar terug, en de blokkade reist mee naar elke nieuwe site die op dat sjabloon wordt gebouwd. Zo verklaart Writgo Media ook waarom clusters van vergelijkbare blokkaderegels steeds terugkomen bij compleet losstaande organisaties, simpelweg omdat het kopieën van kopieën zijn.
Een veelgemaakte fout is om alle AI-crawlers over één kam te scheren. Dat is jammer, want er zit verschil in wat een bot komt doen. GPTBot en ClaudeBot halen content op om taalmodellen te trainen, dat is een eenmalige, structurele bezoeker die je best kunt weigeren als je liever niet hebt dat je content in een trainingsset belandt. OAI-SearchBot en Claude-SearchBot werken anders, want die halen actuele pagina's op zodra iemand in ChatGPT of Claude een vraag stelt die om een actueel antwoord vraagt, vergelijkbaar met hoe Googlebot werkt voor de reguliere zoekresultaten. En dan is er nog een derde categorie, agents als ChatGPT-User en Claude-User, die live meekijken wanneer een gebruiker de AI vraagt om een specifieke pagina te openen of samen te vatten.
Blokkeer je de eerste groep, dan verlies je in principe niets aan directe vindbaarheid, hooguit train je de modellen van morgen niet mee met je content. Blokkeer je de tweede of derde groep, dan verdwijn je actief uit de antwoorden die vandaag aan gebruikers worden getoond. Uit het onderzoek blijkt dat sites dit onderscheid zelden maken. OAI-SearchBot wordt door 8,4 procent geblokkeerd en ChatGPT-User door 11,8 procent, bijna net zo vaak als de trainingsbot GPTBot zelf. Dat is voor de meeste sites waarschijnlijk niet de bedoeling geweest.
Dit hoeft geen project van weken te zijn. Met een half uur en toegang tot je robots.txt-bestand kom je al een heel eind.
Een paar dingen gaan structureel mis. Het toevoegen van een llms.txt zonder ooit te checken of robots.txt die bots nog steeds blokkeert, is de meest voorkomende. Het bestand wijst dan naar content die de crawler niet eens mag ophalen. Ook zien we regelmatig dat een caching-plugin of CDN-instelling een aparte, oudere versie van robots.txt serveert dan de versie die in de WordPress-instellingen staat, waardoor een aanpassing in het CMS niets verandert aan wat een crawler daadwerkelijk te zien krijgt. En een IP-blokkade van een firewall of security-tool via de hostingpartij valt volledig buiten robots.txt, dus zelfs een perfect robots.txt-bestand garandeert niet dat een bot ook echt binnenkomt. Test daarom altijd met een losse tool die de daadwerkelijke serverresponse controleert, niet alleen het robots.txt-bestand zelf.
Nee. Google-Extended staat los van de reguliere Googlebot die je site indexeert voor de klassieke zoekresultaten. Blokkeer je Google-Extended, dan gebruikt Google je content niet voor Gemini en AI Overviews, maar je positie in de gewone zoekresultaten blijft ongemoeid.
Nee, en dat is precies het punt van dit onderzoek. Alleen de zoek- en gebruikersgerichte bots, zoals OAI-SearchBot en ChatGPT-User, bepalen of je site in een actueel antwoord kan opduiken. Trainingsbots als GPTBot blokkeren heeft daar op de korte termijn geen invloed op.
Nee. robots.txt bepaalt welke bots toegang krijgen tot je site. Een llms.txt-bestand is geen toegangsregeling maar een leeswijzer, een kort en gestructureerd overzicht van je belangrijkste content dat het een AI-systeem makkelijker maakt om je pagina's correct samen te vatten of te citeren.
Leidt het team voor SEO, GEO en websites en werkt aan zichtbaarheid in Google én in AI-antwoorden, van techniek tot content. Vragen over dit artikel? Plan een strategiegesprek of bekijk het hele team.
Sander·Teamlead SEO, GEO & Website Sander·Teamlead SEO, GEO & Website